JSON 설계의 장점
스키마 유연성
DROP TABLE IF EXISTS product_flex;
CREATE TABLE product_flex (
    product_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(200) NOT NULL,
    category VARCHAR(100) NOT NULL,
    attributes JSON,
    created_at DATETIME NOT NULL DEFAULT NOW()
);
-- 초기 상품 등록
INSERT INTO product_flex (name, category, attributes) VALUES
('갤럭시 S24', '스마트폰', '{"brand": "삼성", "price": 1200000}');

-- 나중에 새로운 속성 추가 - ALTER TABLE 불필요
INSERT INTO product_flex (name, category, attributes) VALUES
('갤럭시 S25', '스마트폰', '{"brand": "삼성", "price": 1300000, "ai_features": ["통역", "요약", "검색"], "satellite_sos": true}');

-- 두 상품 모두 정상 조회
SELECT name, attributes->>'$.brand' AS brand, attributes->>'$.ai_features' AS ai_features
FROM product_flex;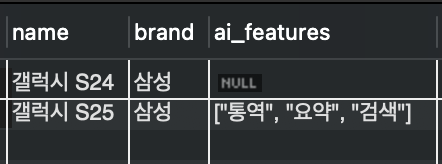
- 일반 컬럼이었다면 "ALTER TABLE ADD COLUMN"이 필요했을 것이다.
- 대용량 테이블에서 "ALTER TABLE"은 상당한 시간이 소요될 수 있다.
복잡한 중첩 구조 표현
-- 일반 관계형 모델: 3개 테이블 필요
-- product, product_spec, product_spec_detail
-- JSON: 하나의 컬럼에 모두 표현
INSERT INTO product_flex (
    name,
    category,
    attributes
)
VALUES (
    '맥북 프로 16',
    '노트북',
    JSON_OBJECT(
        'brand', '애플',
        'price', 3500000,
        'specs', JSON_OBJECT(
            'display', JSON_OBJECT(
                'size', 16.2,
                'resolution', '3456x2234',
                'technology', 'Liquid Retina XDR',
                'refresh_rate', 120
            ),
            'processor', JSON_OBJECT(
                'name', 'M3 Max',
                'cores', JSON_OBJECT(
                    'performance', 12,
                    'efficiency', 4
                ),
                'gpu_cores', 40
            ),
            'memory', JSON_OBJECT(
                'size', 36,
                'type', 'Unified Memory',
                'bandwidth', '400GB/s'
            )
        )
    )
);

-- 중첩된 값 조회
SELECT
    name,
    attributes->>'$.specs.processor.name' AS cpu,
    attributes->>'$.specs.processor.cores.performance' AS p_cores,
    attributes->>'$.specs.memory.size' AS ram
FROM product_flex
WHERE category = '노트북';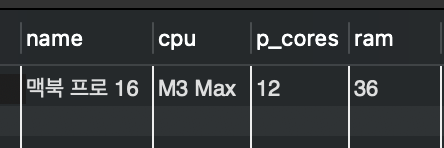
- 관계형 모델에서는 여러 테이블로 분리해야 하는 중첩 구조를 하나의 컬럼에 표현할 수 있다.
개발 생산성 향상
-- 애플리케이션의 설정 객체를 그대로 저장
INSERT INTO product_flex (
    name,
    category,
    attributes
)
VALUES (
    '사용자 대시보드',
    '설정',
    '{
        "layout": {
            "columns": 3,
            "widgets": [
                {"id": "sales", "position": 1, "size": "large"},
                {"id": "visitors", "position": 2, "size": "medium"},
                {"id": "orders", "position": 3, "size": "medium"}
            ]
        },
        "theme": "dark",
        "refresh_interval": 30
    }'
);
- 애플리케이션에서 객체나 JSON을 그대로 저장하고 조회할 수 있어 개발이 단순해진다.
- ORM이나 애플리케이션 코드에서 복잡한 매핑 없이 JSON 객체를 그대로 사용할 수 있다.
EAV 대비 장점
EAV vs JSON 비교
- 상품 하나에 속성 5개인 경우
- EAV: 6개 행 (상품 1행 + 속성 5행), JOIN 필요
- JSON: 1개 행, JOIN 불필요
-- EAV
SELECT p.name,
    MAX(CASE WHEN pa.attr_name = 'brand' THEN pa.attr_value END) AS brand,
    MAX(CASE WHEN pa.attr_name = 'price' THEN pa.attr_value END) AS price
FROM product p
JOIN product_attribute pa ON p.product_id = pa.product_id
GROUP BY p.product_id, p.name;


-- JSON
SELECT name,
    attributes->>'$.brand' AS brand,
    attributes->>'$.price' AS price
FROM product_flex;- JSON이 훨씬 직관적이고 간단하다.
JSON 설계의 단점
데이터 무결성 부재
-- 잘못된 데이터도 저장됨
INSERT INTO product_flex (name, category, attributes) VALUES
('잘못된 상품1', '스마트폰', '{"brand": "삼성", "price": "백만원"}'), -- 가격이 문자열
('잘못된 상품2','스마트폰', '{"brand": "삼성", "pricee": 1000000}'),-- 속성 오타
('잘못된 상품3','스마트폰', '{"brand": "삼성"}'); -- 필수 속성 누락

-- 모두 정상 저장됨
SELECT name, attributes FROM product_flex WHERE name LIKE '잘못된%';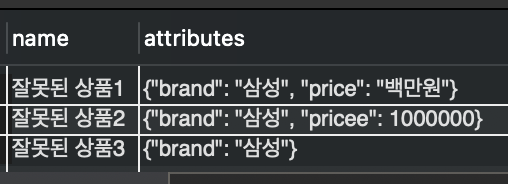
- JSON은 스키마가 없으므로 데이터베이스 수준에서 데이터 무결성을 보장하지 않는다.
- 일반 컬럼이었다면 "price INT NOT NULL"로 이런 문제를 방지할 수 있었다.
CHECK 제약조건으로 일부 보완
MySQL 8.0.16부터 JSON에 CHECK 제약조건을 사용할 수 있다.
DROP TABLE IF EXISTS product_validated;

CREATE TABLE product_validated (
    product_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(200) NOT NULL,
    attributes JSON NOT NULL,
    -- JSON 유효성 검사
    CONSTRAINT chk_brand CHECK (
        JSON_CONTAINS_PATH(attributes, 'one', '$.brand')
    ),
    CONSTRAINT chk_price CHECK (
        JSON_CONTAINS_PATH(attributes, 'one', '$.price')
        AND JSON_TYPE(attributes->'$.price') = 'INTEGER'
    )
);

-- 정상 데이터
INSERT INTO product_validated (
    name,
    attributes
)
VALUES (
    '정상 상품',
    '{"brand": "삼성", "price": 1200000}'
);
무결성 보장
-- brand 누락 - 실패
INSERT INTO product_validated (name, attributes) VALUES
('실패 상품', '{"price": 1200000}');

-- Error Code: 3819. Check constraint 'chk_brand' is violated.

-- price가 문자열 - 실패
INSERT INTO product_validated (name, attributes) VALUES
('실패 상품' , '{"brand": "삼성", "price": "백만원"}');

-- Error Code: 3819. Check constraint 'chk_price' is violated.- 하지만 CHECK 제약조건은 복잡한 검증에 한계가 있고, 성능 오버헤드도 있다.
참조 무결성 불가
-- 일반 컬럼은 외래 키 가능
CREATE TABLE order_item (
	item_id BIGINT PRIMARY KEY,
	product_id BIGINT,
	FOREIGN KEY (product_id) REFERENCES product(product_id)
);
-- JSON 내부 값은 외래 키 불가능
-- {"product_id": 1} 이 값이 실제로 존재하는 product인지 DB가 검증 불가- JSON 내부의 값으로는 외래 키를 설정할 수 없다.
집계와 분석의 어려움
-- 일반 컬럼: 단순 집계
SELECT category, AVG(price), COUNT(*)
FROM product
GROUP BY category;

-- JSON: 복잡한 집계
SELECT
    category,
    AVG(attributes->'$.price') AS avg_price,
    COUNT(*) AS cnt
FROM product_flex
WHERE attributes->'$.price' IS NOT NULL
GROUP BY category;- JSON 데이터에 대한 집계 쿼리는 복잡하고 성능이 떨어진다.
- 대규모 분석 작업에서는 JSON보다 일반 컬럼이 효율적이다.
왜 JSON 분석이 더 비효율적일까?
겉으로 보기에는 SQL 한 줄 차이처럼 보이지만, 데이터베이스 내부에서는 비용(Cost) 차이가 크다.
- 파싱(Parsing) 오버헤드
- 일반 컬럼(price)은 데이터베이스가 해당 위치에 "숫자"가 있다는 것을 이미 알고 있어서 바로 읽어낼 수 있다.
- 하지만 JSON은 매 행(Row)마다 JSON 문서를 열고, 내부 구조를 순회하여 "$.price"라는 키를 찾는 과정이 필요하다.
- 데이터가 100만 건이면 이 '찾는 과정'도 100만 번 반복된다.
- 비유하자면, 일반 컬럼은 진열장에 놓인 물건을 바로 집는 것이고, JSON은 포장된 택배 박스를 일일이 뜯어서 물건을 확인하는 것과 같다.
- 이런 오버헤드 때문에 일반 컬럼보다 JSON이 약간은 더 느리다.
- 데이터 용량과 I/O
- JSON은 값뿐만 아니라 키(key) 정보도 함께 저장한다.
- "{ "price": 10000 }" 이라는 데이터는 단순히 숫자 "10000"만 저장하는 것보다 훨씬 많은 저장 공간을 차지한다.
- 분석을 위해 대량의 데이터를 메모리로 로드할 때, 불필요한 키 정보까지 함께 읽어야 하므로 디스크 I/O와 메모리 효율이 떨어진다.
결국 대규모 데이터 분석이나 통계가 주 목적이라면, 해당 필드는 JSON 밖으로 꺼내어 정규화된 일반 컬럼으로 만드는 것이 정석이다. JSON의 유연함은 "저장"과 "조회"에는 강력하지만, "연산"에는 비용이 더 많이 든다는 점을 기억하자.
저장 공간
JSON은 키 이름도 함께 저장하므로 동일한 데이터라도 일반 컬럼보다 저장 공간을 더 사용한다.
DROP TABLE IF EXISTS product_flex;
DROP TABLE IF EXISTS product_normal;

-- 1. JSON 구조를 사용하는 테이블 생성
CREATE TABLE product_flex (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    category VARCHAR(50),
    attributes JSON
);

-- 2. 일반적인 정규화 구조를 사용하는 테이블 생성
CREATE TABLE product_normal (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    category VARCHAR(50),
    brand VARCHAR(50),
    price INT,
    stock INT
);

-- 3. 데이터 입력 (JSON 테이블)
INSERT INTO product_flex (
    category,
    attributes
)
VALUES (
    '스마트폰',
    '{"brand": "Samsung", "price": 1200000, "stock": 100}'
);

-- 4. 데이터 입력 (일반 테이블)
INSERT INTO product_normal (
    category,
    brand,
    price,
    stock
)
VALUES (
    '스마트폰',
    'Samsung',
    1200000,
    100
);

-- 데이터 크기 비교
SELECT
    'JSON' AS type,
    SUM(LENGTH(attributes)) AS total_bytes
FROM product_flex
WHERE category = '스마트폰'

UNION ALL

SELECT
    'Normal' AS type,
    SUM(LENGTH(brand) + 4 + 4) AS total_bytes -- brand VARCHAR + price INT + stock INT
FROM product_normal
WHERE category = '스마트폰';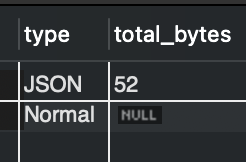
- 동일한 데이터를 저장할 때 JSON이 더 많은 공간을 사용한다.
'데이터 베이스 > 설계 2편, 실무에서 반드시 마주치는 9가지 설계 패턴' 카테고리의 다른 글
| Ch08. JSON 설계 - 관계형 데이터베이스 vs NoSQL (0) | 2026.08.01 |
|---|---|
| Ch08. JSON 설계 - JSON 사용 가이드라인 (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 인덱스와 성능 최적화 (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 활용 (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 사용하기(2) (0) | 2026.08.01 |