JSON은 스키마 없는 유연함을 제공하지만, 데이터가 쌓였을 때의 성능 문제는 반드시 고민해야 한다. 많은 학생들이 "JSON은 인덱스를 걸 수 없으니 느리지 않나요?"라고 질문한다. 결론부터 말하면 JSON 내부의 데이터도 인덱스를 걸 수 있고, 매우 빠르게 조회할 수 있다
JSON 검색 성능의 문제점
-- 실행 계획 확인 (인덱스 없음)
EXPLAIN
SELECT * FROM product_json
WHERE attributes->'$.storage' = 256;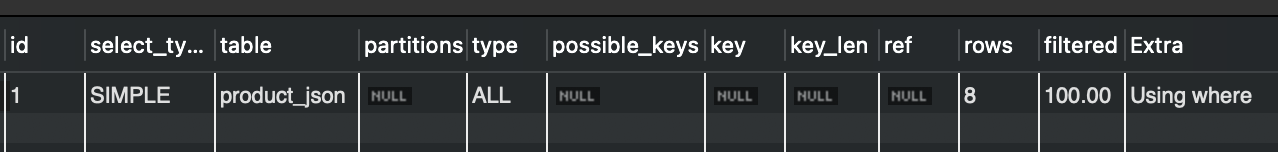
- type: ALL: 이것은 풀 테이블 스캔(Full Table Scan)을 의미한다.
- 데이터베이스가 테이블의 첫 번째 행부터 마지막 행까지 모든 JSON을 하나하나 열어서 "storage" 값을 확인했다는 뜻이다.
- 데이터가 8개일 때는 순식간이지만, 데이터가 100만 개라면 매우 느린 쿼리가 될 것이다
일반적인 인덱스 생성 방식("CREATE INDEX ... ON table(column)")으로는 JSON 컬럼 전체를 인덱싱할 뿐, JSON 내부의 특정 키($.storage)를 인덱싱할 수 없다. 이를 해결하기 위해 MySQL은 가상 컬럼(Virtual Column) 기능을 제공한다.
가상 컬럼(Virtual Column)을 활용한 인덱스
MySQL 5.7부터 지원하는 가상 컬럼을 사용하면 JSON 내부의 특정 필드를 마치 별도의 컬럼처럼 추출하고, 여기에 인덱스도 걸 수 있다.
가상 컬럼 생성
ALTER TABLE product_json
ADD COLUMN v_storage INT GENERATED ALWAYS AS (attributes->'$.storage') VIRTUAL;- GENERATED ALWAYS AS (...): 괄호 안의 식을 통해 값이 자동으로 생성된다는 뜻이다.
- VIRTUAL: 이 컬럼은 실제로 디스크에 저장되지 않고, 조회할 때만 계산된다.
- 따라서 추가적인 저장 공간을 거의 차지하지 않는다.
SELECT product_id, name, v_storage FROM product_json;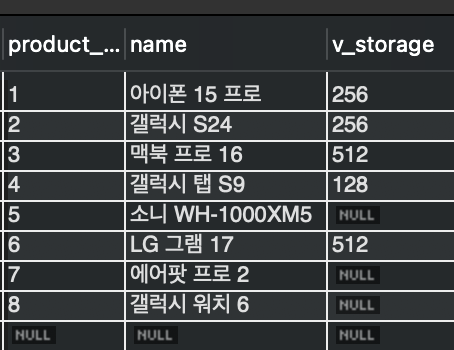
- 데이터를 조회해보면 "v_storage"라는 컬럼이 생긴 것을 확인할 수 있다.
- 이 가상 컬럼을 사용하면 JSON의 "$.storage" 값을 일반적인 테이블의 컬럼처럼 접근할 수 있다.
왜 가상(Virtual) 컬럼인가?
여기서 "v_storage" 컬럼은 겉보기에는 일반적인 컬럼과 똑같아 보인다. 하지만 실제로는 테이블에 데이터가 저장되지 않는다. 이것이 가상(Virtual) 컬럼이라고 불리는 이유다. 일반적인 컬럼이라면 데이터를 추가할 때마다 디스크 공간을 차지하지만, 가상 컬럼은 "이 컬럼의 값은 JSON의 "$.storage" 경로에서 가져온다"라는 계산식(메타데이터)만 저장한다. 데이터베이스가 이 컬럼을 읽어야 할 때마다 원본 JSON을 참조해서 값을 그때그때 계산해서 보여주는 것이다. 마치 엑셀(Excel)에서 값이 고정된 셀이 아니라 수식이 걸려있는 셀과 비슷하다고 이해하면 된다. 여기서는 "(attributes->'$.storage')"와 같은 수식이 걸려있는 것이다
장점
- 저장 공간 절약: 데이터를 중복해서 저장하지 않으므로 디스크 공간을 아낄 수 있다.
- JSON 문서가 매우 크고 데이터가 많을수록 이 장점은 커진다.
- 데이터 무결성 유지: 원본 JSON 데이터(attributes)가 변경되면 가상 컬럼(v_storage)의 값도 자동으로 변경된다.
- 개발자가 두 곳의 데이터를 맞추기 위해 별도로 업데이트 로직을 짤 필요가 없다.
가상 컬럼은 실제 데이터는 없지만, 일반 컬럼처럼 인덱스(B-Tree)를 생성할 수 있다. 이것이 JSON 최적화의 핵심이다.
가상 컬럼에 인덱스 생성
CREATE INDEX idx_v_storage ON product_json(v_storage);- 가상 컬럼에 일반적인 B-Tree 인덱스를 생성한다.
성능 개선 확인
-- 가상 컬럼을 이용한 조회
EXPLAIN
SELECT * FROM product_json WHERE v_storage = 256;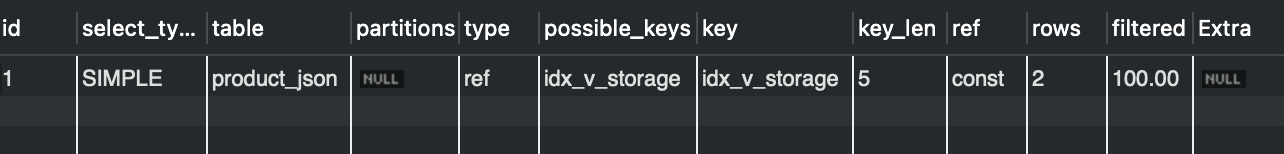
- type: ref: 풀 테이블 스캔이 사라지고 인덱스를 타게 되었다.
- key: idx_v_storage: 우리가 만든 인덱스가 사용되었다.
인덱스를 사용하는 것을 확인할 수 있을 것이다. 혹은 MySQL 옵티마이저가 똑똑하기 때문에, 원본 JSON 경로로 조회해도 식(Expression)이 일치하면 자동으로 인덱스를 사용한다.
-- JSON 경로로 조회해도 인덱스 적용됨
EXPLAIN
SELECT * FROM product_json
WHERE attributes->'$.storage' = 256;- 이 방식을 사용하면 JSON의 유연함은 유지하면서도, 자주 조회하는 필드(예: sku, price, category_id 등)에 대해서는 관계형 데이터베이스의 강력한 성능을 그대로 누릴 수 있다.
VIRTUAL vs STORED
MySQL의 생성 컬럼(Generated Column)은 데이터를 저장하는 방식에 따라 "VIRTUAL"과 "STORED" 두 가지 타입으로 나뉜다.
VIRTUAL
ALTER TABLE product_json
ADD COLUMN v_storage INT GENERATED ALWAYS AS (attributes->'$.storage') VIRTUAL;
- VIRTUAL은 기본값이다. 생략할 수 있다.
STORED
ALTER TABLE product_json
ADD COLUMN v_storage INT GENERATED ALWAYS AS (attributes->'$.storage') STORED;- 실무에서는 대부분 "VIRTUAL"을 사용하며, "STORED"는 특별한 이유가 없다면 잘 사용하지 않는다.
차이점 비교
가장 큰 차이는 "데이터를 디스크에 실제로 저장하느냐"이다.
VIRTUAL (기본값)
- 데이터를 디스크에 저장하지 않는다. (메타데이터만 저장)
- "INSERT"나 "UPDATE" 시에는 계산하지 않고, 데이터를 "SELECT" 할 때마다 CPU가 계산해서 보여준다.
- 저장 공간을 차지하지 않아 효율적이다.
STORED
- 데이터를 디스크에 물리적으로 저장한다.
- "INSERT"나 "UPDATE" 될 때 미리 계산해서 저장해둔다.
- 저장 공간을 추가로 차지하지만, 읽을 때 CPU 연산이 필요 없다.
| 특징 | VIRTUAL (가상) | STORED (저장) |
| 저장 공간 | 거의 없음 (메타데이터만) | 추가 공간 필요 (물리적 저장) |
| 값 계산 시점 | 데이터를 읽을 때 (Read Time) | 데이터를 쓸 때 (Write Time) |
| 쓰기 성능 | 빠름 (계산 부하 적음) | 느림 (계산 및 저장 부하 발생) |
| 동기화 | 원본 변경 시 자동 반영 | 원본 변경 시 자동 업데이트 |
| 실무 활용도 | 매우 높음 | 낮음 |
왜 실무에서는 VIRTUAL을 선호하는가?
VIRTUAL 컬럼에 인덱스를 걸면, 그 인덱스 정보는 디스크에 물리적으로 저장된다.
우리가 "idx_v_storage" 인덱스를 만드는 순간, 이미 "storage" 값들이 B-Tree 형태로 디스크에 예쁘게 정렬되어 저장된다는 뜻이다. 따라서 인덱스를 통해 조회할 때는 매번 계산하는 것이 아니라, 이미 저장된 인덱스 값을 바로 찾아가므로 "STORED"와 성능 차이가 거의 없다. 오히려 "STORED"를 사용하면 다음에서 2번 과정에 중복 낭비가 발생한다.
- JSON 원본 데이터 저장
- "STORED" 컬럼 데이터 저장 (중복 저장)
- 인덱스 데이터 저장
굳이 2번 과정을 통해 디스크 용량을 낭비하고 쓰기 성능을 떨어뜨릴 이유가 없다. 따라서 JSON 데이터를 인덱싱할 때는 "VIRTUAL" 방식이 표준이라고 생각하면 된다
STORED는 언제 쓰는가?
"STORED" 방식은 JSON 추출 비용보다 훨씬 더 복잡하고 무거운 계산이 필요하거나, 해당 컬럼을 PK(Primary Key)로 설정해야 하는 등 제약 사항이 있을 때만 제한적으로 사용한다. 일반적인 JSON 필드 인덱싱 목적이라면 "VIRTUAL"만으로 충분하다.
함수 기반 인덱스 (Function-Based Index)
MySQL 8.0.13 버전부터는 가상 컬럼을 명시적으로 만들지 않고도, 함수(수식)의 결과에 대해 직접 인덱스를 생성할 수 있는 함수 기반 인덱스 기능을 지원한다
함수 기반 인덱스 생성
-- 가상 컬럼 생성 과정 없이 바로 인덱스 생성
CREATE INDEX idx_func_storage
ON product_json (( CAST(attributes->'$.storage' AS UNSIGNED) ));

-- 가상 컬럼 생성 과정 없이 바로 인덱스 생성 (CAST 없음)
CREATE INDEX idx_func_storage
ON product_json ((JSON_VALUE(attributes, '$.storage' RETURNING UNSIGNED)));
- 인덱스를 생성할 때 컬럼명 대신 "(수식)"을 이중 괄호로 감싸서 넣어주면 된다.
- "JSON_VALUE"를 사용하면서 타입을 직접 지정할 수 있다.
- "(( ... ))": 수식을 인덱스로 사용할 때는 반드시 이중 괄호를 사용해야 한다.
- 타입을 지정해야 한다. (인덱스는 사용할 타입을 알아야 한다.)
내부적으로는 MySQL이 우리가 앞서 배운 "가상 컬럼"을 자동으로 생성하고 거기에 인덱스를 거는 방식으로 동작한다. 즉, 성능상 차이는 없고 사용 편의성을 높인 기능(Syntactic Sugar)이다.
실행 결과 확인
EXPLAIN
SELECT * FROM product_json
WHERE attributes->'$.storage' = 256;
- 인덱스가 정상적으로 적용되는 것을 볼 수 있다.
실무에서는 가상 컬럼이 다른 조회 쿼리에서도 "SELECT" 절에 자주 등장한다면 가상 컬럼 방식을, 오직 "WHERE" 절의 검색 조건으로만 쓰인다면 함수 기반 인덱스를 사용하여 스키마를 깔끔하게 유지하는 것을 추천한다.
멀티 밸류 인덱스 (Multi-Valued Index)
가상 컬럼 인덱스는 값이 하나인 경우(1:1)에는 완벽하다. 하지만 JSON 배열 안에 있는 값을 검색해야 한다면 어떻게 해야 할까?
MySQL 8.0.17부터 도입된 멀티 밸류 인덱스는 하나의 행(JSON 배열)에 여러 개의 인덱스 키를 매핑할 수 있게 해준다.
멀티 밸류 인덱스 생성
문법이 조금 독특하니 주의 깊게 봐야 한다. 앞서 배운 함수 기반 인덱스에 "CAST(... AS ... ARRAY)"를 사용해야 한다.
-- ports 배열에 대한 멀티 밸류 인덱스 생성
CREATE INDEX idx_ports
ON product_json (( CAST(attributes->'$.ports' AS CHAR(20) ARRAY) ));- "CAST(... AS ... ARRAY)": JSON 배열의 요소들을 지정한 타입(여기서는 문자, "CHAR(20)")으로 변환하여 인덱싱하겠다는 의미다.
- 이중 괄호 "(( ... ))"를 사용하는 것에 주의하자.
멀티 밸류 인덱스 활용 함수
멀티 밸류 인덱스를 타게 하려면 다음 함수들을 사용해야 한다.
- "MEMBER OF()" : 특정 값이 배열에 있는지 확인
- "JSON_CONTAINS()" : 특정 JSON이 포함되어 있는지 확인
- "JSON_OVERLAPS()" : 두 배열 간에 겹치는 요소가 있는지 확인
성능 개선 확인
-- HDMI 포트가 있는 제품 검색
EXPLAIN
SELECT product_id, name, attributes->>'$.ports'
FROM product_json
WHERE 'HDMI' MEMBER OF(attributes->'$.ports');
- "key: idx_ports": 멀티 밸류 인덱스가 정상적으로 작동하여, 배열 내부의 값을 고속으로 검색했다.
"JSON_CONTAINS"를 사용할 수도 있다.
EXPLAIN
SELECT product_id, name
FROM product_json
WHERE JSON_CONTAINS(attributes->'$.ports', '"USB-C"');
- "JSON_CONTAINS"는 타겟 값이 JSON 형식이어야 하므로 문자열은 '"USB-C"' 처럼 따옴표를 두 번 써야 한다.
정리
JSON 인덱스 핵심은 다음과 같다.
- 가상 컬럼(Generated Column) + 인덱스로 JSON 값 검색 최적화
- 함수 기반 인덱스로 가상 컬럼 없이 인덱스 생성 가능 (MySQL 8.0.13+)
- Multi-Valued Index로 JSON 배열 검색 최적화 (MySQL 8.0.17+)
성능 최적화 전략은 다음과 같다.
- 자주 검색하는 속성은 가상 컬럼으로 추출하여 인덱스 적용
- 하이브리드 설계: 검색용 속성은 일반 컬럼, 유동적 속성은 JSON
- JSON 크기를 적절히 유지
- 전체 교체 대신 부분 업데이트 활용
인덱스 없는 JSON 검색은 전체 테이블 스캔을 유발하므로, 검색이 필요한 JSON 속성에는 반드시 인덱스 전략을 수립해야 한다.
'데이터 베이스 > 설계 2편, 실무에서 반드시 마주치는 9가지 설계 패턴' 카테고리의 다른 글
| Ch08. JSON 설계 - JSON 사용 가이드라인 (0) | 2026.08.01 |
|---|---|
| Ch08. JSON 설계 - JSON 설계의 장단점과 한계 (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 활용 (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 사용하기(2) (0) | 2026.08.01 |
| Ch08. JSON 설계 - JSON 사용하기(1) (0) | 2026.07.31 |