EAV의 장점
- 스키마 유연성
- 가장 큰 장점은 테이블 구조 변경 없이 새로운 속성을 추가할 수 있다는 것이다.
- 운영 중인 시스템에서 "ALTER TABLE"을 실행하는 것은 위험하고 시간이 오래 걸릴 수 있다.
- EAV는 이 문제를 완전히 해결한다.
- 희소 데이터 효율성
- 전통적인 테이블에서 100개의 속성 컬럼이 있는데, 각 상품이 평균 10개의 속성만 사용한다면?
- 90개의 컬럼에는 NULL이 저장되어 공간이 낭비된다.
- EAV는 실제 값이 있는 속성만 저장하므로 희소 데이터에 효율적이다.
- 전통적인 테이블에서 100개의 속성 컬럼이 있는데, 각 상품이 평균 10개의 속성만 사용한다면?
- 엔티티별 다른 속성 지원
- 같은 카테고리라도 상품마다 다른 속성을 가질 수 있다.
- 셀러가 원하는 속성을 자유롭게 추가할 수 있다.
- 런타임 속성 정의
- 관리자 화면에서 새로운 속성을 정의하고 바로 사용할 수 있다.
- 개발자의 도움 없이 운영팀이 직접 속성을 관리할 수 있다.
EAV의 단점
쿼리 복잡성
여러 속성을 조회하거나 조건으로 검색하려면 복잡한 조인이나 서브쿼리가 필요하다.
-- 전통적 테이블: 간단한 쿼리
SELECT * FROM product_phone
WHERE screen_size >= '6.0' AND ram = '12GB';

-- EAV: 복잡한 쿼리
SELECT p.* FROM product p
WHERE p.product_id IN (
    SELECT product_id FROM product_attribute
    WHERE attr_name = 'screen_size' AND attr_value >= '6.0'
)
AND p.product_id IN (
    SELECT product_id FROM product_attribute
    WHERE attr_name = 'ram' AND attr_value = '12GB'
);
데이터 타입 제약 부족
-- 잘못된 데이터도 입력 가능
INSERT INTO product_attribute (product_id, attr_name, attr_value) VALUES
(1, 'price_discount', '할인중'); -- 숫자여야 하는데 문자열- 모든 값이 VARCHAR로 저장되므로 데이터베이스 수준의 타입 검증이 불가능하다. 숫자여야 하는 값에 문자열이 들어갈 수 있다.
- 애플리케이션 레벨에서 검증 로직을 구현해야 한다.
참조 무결성 제약 어려움
- 외래 키 제약조건을 걸기 어렵다.
- 예를 들어, 색상 값이 특정 색상 테이블을 참조해야 한다면 EAV에서는 이를 데이터베이스 수준에서 강제할 수 없다.
인덱싱 제한
- 특정 속성에 대한 효율적인 인덱스 생성이 어렵다.
- 전통적인 테이블에서는 "CREATE INDEX idx_ram ON product_phone(ram)"으로 RAM 컬럼에 인덱스를 생성할 수 있다.
- EAV에서는 모든 속성이 같은 컬럼에 저장되므로 특정 속성만을 위한 인덱스를 만들기 어렵다.
조인 성능 저하
- 속성이 많아질수록 쿼리나 다중 조인의 성능이 떨어진다.
실무 팁: 데이터 타입별 컬럼 분리
EAV 패턴의 가장 큰 약점인 데이터 타입 정합성 문제를 해결하기 위해, 실무에서는 값(Value)을 저장하는 컬럼을 데이터 타입별로 분리하기도 한다. 모든 값을 하나의 `VARCHAR` 컬럼에 억지로 넣는 대신, 문자형, 숫자형, 날짜형 등으로 컬럼을 나누어 설계하는 방식이다.
DROP TABLE IF EXISTS product_attribute_typed;
CREATE TABLE product_attribute_typed (
	attribute_id BIGINT NOT NULL AUTO_INCREMENT,
    product_id BIGINT NOT NULL,
    attr_name VARCHAR(100) NOT NULL,
    val_text VARCHAR(255) NULL,
    val_int INT NULL,
    val_date DATETIME NULL,
	PRIMARY KEY (attribute_id)
)- EAV 패턴의 가장 큰 약점인 데이터 타입 정합성 문제를 해결하기 위해, 실무에서는 값(Value)을 저장하는 컬럼을 데이터 타입별로 분리하기도 한다.
- 모든 값을 하나의 VARCHAR 컬럼에 억지로 넣는 대신, 문자형, 숫자형, 날짜형 등으로 컬럼을 나누어 설계하는 방식이다.
- 이 예제는 단순하게 설명하기 위해 "attr_def_id" 대신에 "attr_name"을 그대로 사용했다.
데이터 저장 예시
-- 화면 패널 종류 (문자열)
INSERT INTO product_attribute_typed (product_id, attr_name, val_text)
VALUES (1, 'panel_type', 'OLED');

-- 배터리 용량 (숫자)
INSERT INTO product_attribute_typed (product_id, attr_name, val_int)
VALUES (1, 'battery_capacity', 5000);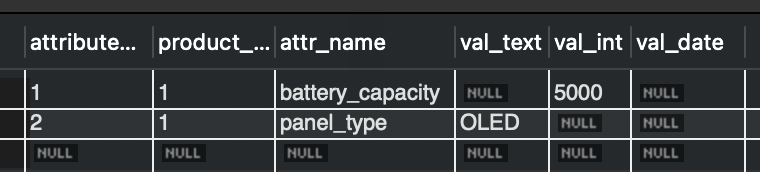
장점
- 데이터 타입 보장: 숫자 컬럼에 문자가 들어가는 것을 DB 차원에서 막을 수 있다.
- 연산 및 정렬 효율성: 숫자는 숫자로, 날짜는 날짜로 저장되므로 "ORDER BY" 정렬이나 "BETWEEN" 같은 범위 검색 시 올바르게 작동하며 인덱스도 효율적으로 탈 수 있다.
- 예를 들어, 문자열로 저장된 "10"과 "2"를 비교하면 "10"이 더 작다고 판단될 수 있지만, 숫자형 컬럼을 따로 쓰면 이런 문제를 피할 수 있다.
물론, 하나의 로우(Row)에 사용하지 않는 나머지 타입 컬럼들은 NULL로 채워지게 된다는 점은 감수해야 한다. 하지만 데이터 무결성이 중요한 커머스 환경에서는 매우 유용한 타협안이 될 수 있다.
EAV 사용 시 주의사항
핵심 속성은 EAV에 넣지 말 것
-- 좋은 예: 핵심 속성은 product 테이블에
CREATE TABLE product (
    product_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    category_id BIGINT NOT NULL,
    name VARCHAR(200) NOT NULL,
    price INT NOT NULL, -- 핵심 속성
    brand VARCHAR(100), -- 핵심 속성
    status VARCHAR(20), -- 핵심 속성
    created_at DATETIME NOT NULL,
    FOREIGN KEY (category_id) REFERENCES category(category_id)
);

-- 부가 속성만 EAV로
CREATE TABLE product_attribute (
    attribute_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    product_id BIGINT NOT NULL,
    attr_def_id BIGINT NOT NULL,
    attr_value VARCHAR(500),
    FOREIGN KEY (product_id) REFERENCES product(product_id)
);- 자주 조회되고, 검색 조건으로 사용되며, 데이터 무결성이 중요한 속성은 메인테이블의 컬럼으로 정의한다.
- 핵심 속성은 반드시 메인테이블의 컬럼으로 사용해야 한다.
- 부가 속성만 EAV를 사용한다.
하이브리드 접근
- 완전한 EAV 보다는 "핵심 속성 + EAV"의 하이브리드 방식을 권장한다.
- 자주 사용되는 속성은 컬럼으로, 동적으로 변하는 속성은 EAV로 관리한다.
EAV 실무 활용 사례
쇼핑몰 상품 상세 스펙
- 앞서 살펴본 것처럼, 오픈마켓이나 쇼핑몰에서 다양한 카테고리의 상품 스펙을 관리할 때 EAV를 사용한다.
설문조사/폼 빌더
- 동적으로 질문을 생성하고 응답을 저장하는 시스템에서 EAV가 유용하다.
-- 설문 정의
CREATE TABLE survey (
    survey_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    title VARCHAR(200) NOT NULL,
    created_at DATETIME NOT NULL
);
-- 질문 정의 (Attribute Definition)
CREATE TABLE survey_question (
    question_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    survey_id BIGINT NOT NULL,
    question_text VARCHAR(500) NOT NULL,
    question_type VARCHAR(20) NOT NULL, -- TEXT, RADIO, CHECKBOX
    options VARCHAR(500),
    display_order INT,
    FOREIGN KEY (survey_id) REFERENCES survey(survey_id)
);
-- 응답 저장 (EAV)
CREATE TABLE survey_response (
    response_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    survey_id BIGINT NOT NULL,
    respondent_id BIGINT,
    question_id BIGINT NOT NULL,
    answer_value VARCHAR(1000),
    created_at DATETIME NOT NULL,
    FOREIGN KEY (survey_id) REFERENCES survey(survey_id),
    FOREIGN KEY (question_id) REFERENCES survey_question(question_id)
);
의료 시스템의 환자 데이터
- 환자마다 다른 검사 항목, 처방 내역, 증상 기록 등을 저장할 때 EAV가 유용하다. 의료 분야에서는 검사 항목이 수천 가지가 될 수 있고, 환자마다 받는 검사가 다르기 때문이다.
사용자 프로필 확장 속성
- 기본 사용자 정보 외에 각 사용자마다 다른 추가 프로필 정보를 유연하게 관리할 때 사용한다.
-- 기본 사용자 정보
CREATE TABLE users (
    user_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    email VARCHAR(100) NOT NULL UNIQUE,
    name VARCHAR(50) NOT NULL,
    created_at DATETIME NOT NULL
);
-- 확장 프로필 (EAV)
CREATE TABLE user_profile_attribute (
    attr_id BIGINT PRIMARY KEY AUTO_INCREMENT,
    user_id BIGINT NOT NULL,
    attr_name VARCHAR(100) NOT NULL,
    attr_value VARCHAR(500),
    FOREIGN KEY (user_id) REFERENCES users(user_id)
);
-- 사용 예
INSERT INTO user_profile_attribute (user_id, attr_name, attr_value) VALUES
(1, 'github_url', 'https://github.com/user1'),
(1, 'blog_url', 'https://blog.user1.com'),
(1, 'preferred_language', 'ko'),
(2, 'company', 'ABC Corp'),
(2, 'job_title', 'Senior Developer');
EAV 선택에 대한 조언- 최후의 수단 (중요)
"가급적이면 EAV를 사용하지 마라."
이 말이 모순처럼 들릴 수 있겠지만, 이것이 정답이다. EAV는 관계형 데이터베이스(RDBMS)가 제공하는 강력한 이점들을 대부분 포기하는 방식이다.
- 데이터 무결성 포기: 데이터베이스 레벨에서 "NOT NULL", "INT", "DATE" 같은 타입 체크나 외래 키 제약조건을 걸 수 없다.
- 잘못된 데이터가 들어가는 것을 막기 위해 애플리케이션 코드가 매우 복잡해진다.
- SQL 복잡도 증가: 단순한 조회조차 수많은 조인(Join)과 서브쿼리가 필요하다.
- 쿼리를 작성하기도 어렵고, 유지보수하기도 힘들다.
- 성능 저하: 대용량 데이터에서 특정 속성으로 검색하거나 정렬할 때 인덱스를 효율적으로 태우기 어렵다.
그럼 언제 사용해야 하는가?? 기존의 전통적인 테이블 설계(컬럼 추가, 정규화, 상속 관계 등)로는 도저히 해결할 수 없는 "불확실성이 확실한" 상황에서만 사용해야 한다. 단순히 "나중에 속성이 바뀔지도 몰라"라는 막연한 걱정으로 EAV를 도입해서는 안 된다.
현대적인 대안: JSON Type
- 아마도 JSON 형식을 알고 있다면, EAV 대신에 JSON 형식으로 저장하면 더 효율적일 것 같다는 생각이 들 것이다.
- 만약 어쩔 수 없이 EAV 방식을 고려해야 한다면, 그리고 최신 데이터베이스를 사용한다면 JSON 방식을 고려해보자.
- 최신 RDBMS는 JSON 데이터에 대한 인덱싱과 검색 기능을 제공하므로, EAV의 복잡성을 줄이면서 유연성을 확보할 수 있다.
따라서 EAV 대신 JSON 컬럼을 사용하는 것이 더 효율적이다.
CREATE TABLE product (
    product_id BIGINT PRIMARY KEY,
    name VARCHAR(200),
    attributes JSON -- 속성을 JSON으로 저장
);
데이터베이스 설계의 기본은 언제나 명확한 테이블과 컬럼이다. 기본에 충실하되, 정말 어쩔 수 없는 상황에서만 "EAV"라는 무기를 고려하자.
'데이터 베이스 > 설계 2편, 실무에서 반드시 마주치는 9가지 설계 패턴' 카테고리의 다른 글
| Ch08. JSON 설계 - JSON 문법 (0) | 2026.07.29 |
|---|---|
| Ch08. JSON 설계 - EAV의 한계와 JSON 필요성 (0) | 2026.07.29 |
| Ch07. 동적 설계 EAV - 속성 정의 테이블 (0) | 2026.07.27 |
| Ch07. 동적 설계 EAV - EAV 패턴 실습 (0) | 2026.07.27 |
| Ch07. 동적 설계 EAV - EAV 패턴 (0) | 2026.07.27 |