기본 EAV 구조는 유연하지만 몇 가지 문제가 있다. 속성명을 자유롭게 입력할 수 있어서 오타가 발생할 수 있고, 어떤 속성들이 있는지 파악하기 어렵다
속성 정의 테이블 추가
이 문제를 해결하기 위해 속성의 메타데이터를 관리하는 테이블을 추가한다.
DROP TABLE IF EXISTS product_attribute;
DROP TABLE IF EXISTS attribute_definition;
-- 속성 정의 테이블
CREATE TABLE attribute_definition (
	attr_def_id BIGINT PRIMARY KEY AUTO_INCREMENT,
	category_id BIGINT,
	attr_name VARCHAR(100) NOT NULL,
	attr_label VARCHAR(100) NOT NULL,
	attr_type VARCHAR(20) NOT NULL, -- TEXT, NUMBER, BOOLEAN, SELECT
	is_required BOOLEAN DEFAULT FALSE,
	is_searchable BOOLEAN DEFAULT FALSE,
	display_order INT DEFAULT 0,
	options VARCHAR(500), -- SELECT 타입일 때 선택 옵션
	created_at DATETIME NOT NULL,
	FOREIGN KEY (category_id) REFERENCES category(category_id)
);

-- 상품 속성 테이블 (개선)
CREATE TABLE product_attribute (
	attribute_id BIGINT PRIMARY KEY AUTO_INCREMENT,
	product_id BIGINT NOT NULL,
	attr_def_id BIGINT NOT NULL,
	attr_value VARCHAR(500),
	created_at DATETIME NOT NULL,
	FOREIGN KEY (product_id) REFERENCES product(product_id),
	FOREIGN KEY (attr_def_id) REFERENCES attribute_definition(attr_def_id)
);

CREATE INDEX idx_product_attribute_product ON product_attribute(product_id);
CREATE INDEX idx_product_attribute_def ON product_attribute(attr_def_id);- "attr_name"을 직접 저장하는 대신 "attr_def_id"로 속성 정의를 참조한다
- 속성의 타입, 필수 여부, 검색 가능 여부 등 메타데이터를 관리할 수 있다
- "category_id"를 참조해서 카테고리별로 어떤 속성들이 있는지 명확하게 정의된다
- product_attribute 테이블은 이제 속성의 이름 대신에 "attr_def_id"를 통해서 미리 정의된 속성을 참조한다.
참고: 각 상품의 속성의 중복 입력을 막으려면 product_attribute 테이블의 "product_id", "attr_def_id" 컬럼을 묶어서 유니크 제약조건을 적용하면 된다.
속성 정의 데이터 입력
-- 스마트폰 카테고리 속성 정의
INSERT INTO attribute_definition  (category_id, attr_name, attr_label, attr_type, is_required, is_searchable, display_order, options, created_at) VALUES
(2, 'screen_size', '화면 크기', 'TEXT', TRUE, TRUE, 1, NULL, NOW()),
(2, 'battery_capacity', '배터리 용량', 'TEXT', TRUE, TRUE, 2, NULL, NOW()),
(2, 'ram', 'RAM', 'SELECT', TRUE, TRUE, 3, '4GB,6GB,8GB,12GB,16GB', NOW()),
(2, 'storage', '저장 용량', 'SELECT', TRUE, TRUE, 4, '64GB,128GB,256GB,512GB,1TB', NOW()),
(2, 'processor', '프로세서' , 'TEXT', TRUE, FALSE, 5, NULL, NOW()),
(2, 'main_camera', '메인 카메라', 'TEXT', FALSE, TRUE, 6, NULL, NOW()),
(2, 'color', '색상', 'TEXT', TRUE, TRUE, 7, NULL, NOW()),
(2, 'water_resistance', '방수 등급', 'SELECT', FALSE, TRUE, 8, 'IP67,IP68', NOW()),
(2, '5g_support', '5G 지원', 'BOOLEAN', FALSE, TRUE, 9, NULL, NOW());

-- 의류 카테고리 속성 정의
INSERT INTO attribute_definition (category_id, attr_name, attr_label, attr_type, is_required, is_searchable, display_order, options, created_at) VALUES
(5, 'material', '소재', 'TEXT', TRUE, TRUE, 1, NULL, NOW()),
(5, 'size', '사이즈', 'SELECT', TRUE, TRUE, 2, 'XS,S,M,L,XL,XXL', NOW()),
(5, 'color', '색상', 'TEXT', TRUE, TRUE, 3, NULL, NOW()),
(5, 'origin', '원산지', 'TEXT', FALSE, FALSE, 4, NULL, NOW()),
(5, 'washing', '세탁 방법', 'TEXT', FALSE, FALSE, 5, NULL, NOW()),
(5, 'season', '시즌', 'SELECT', FALSE, TRUE, 6, 'S/S,F/W,사계절', NOW());
개선된 구조로 데이터 조회
카테고리별 속성 정의 조회
SELECT
    ad.attr_name,
    ad.attr_label,
    ad.attr_type,
    CASE WHEN ad.is_required THEN 'Y' ELSE 'N' END AS required,
    CASE WHEN ad.is_searchable THEN 'Y' ELSE 'N' END AS searchable,
	ad.options
FROM attribute_definition ad
JOIN category c ON ad.category_id = c.category_id
WHERE c.name = '스마트폰'
ORDER BY ad.display_order;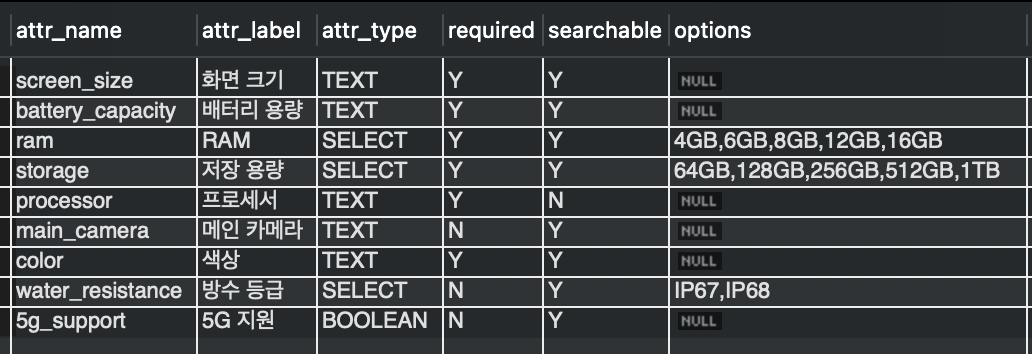
- 참고: "options"를 자주 사용한다면 정규화해서 별도의 테이블로 분리하는 것이 좋다.
- 여기서는 예시를 단순하게 설명하기 위해 CSV 스타일로 저장해두었다.
- "attribute_definition"에 미리 속성을 정의해 둔 덕분에 이제 스마트폰 카테고리에 어떤 속성들이 있고, 각 속성의 특성이 무엇인지 명확하게 알 수 있다.
상품 등록 화면 데이터 제공
속성 정의 테이블을 도입하면 추가적인 이점도 얻을 수 있는데 대표적으로 다음과 같은 이점이 있다. 관리자가 상품을 등록할 때, 해당 카테고리에 필요한 속성 목록을 제공해야 한다.
-- 스마트폰 카테고리 상품 등록 시 필요한 속성 폼 정보
SELECT
    ad.attr_def_id,
    ad.attr_name,
    ad.attr_label,
    ad.attr_type,
    ad.is_required,
    ad.options
FROM attribute_definition ad
WHERE ad.category_id = 2 -- 스마트폰
ORDER BY ad.display_order;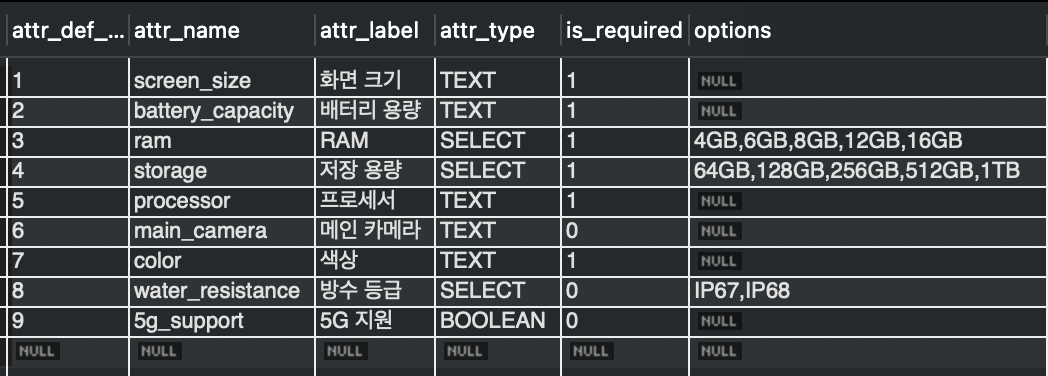
- 이 정보를 바탕으로 프론트엔드에서 동적으로 입력 폼을 생성할 수 있다.
- "attr_type"에 따라 텍스트 입력, 셀렉트 박스, 체크박스 등을 렌더링 한다.
- 물론 속성 정의 테이블에서 사용한 다양한 컬럼들은 비즈니스 요구사항마다 달라진다.
개선된 구조에 속성 값 입력
개선된 구조에 데이터를 입력해보자. 이제 "attr_name" 대신 "attr_def_id" 사용한다.
INSERT INTO product_attribute (product_id, attr_def_id, attr_value, created_at) VALUES
(1, 1, '6.8인치' , NOW()), -- screen_size (id:1)
(1, 2, '5000mAh', NOW()), -- battery_capacity (id:2)
(1, 3, '12GB', NOW()); -- ram (id:3)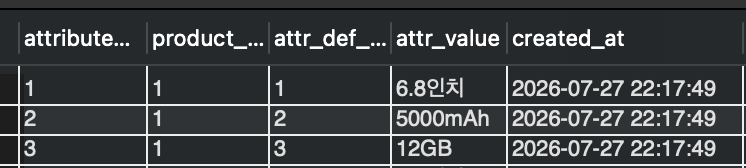
- 이제 "attr_name" 대신 "attr_def_id" 사용하는 것을 확인할 수 있다.
- "attr_name"의 중복이 제거되고, 정규화된다.
개선된 구조의 데이터 조회
이제 개선된 구조에서 데이터를 조회해보자. product_attribute 테이블에는 속성의 구체적인 이름이 없고 "attr_def_id"만 존재하므로, attribute_definition 테이블까지 조인(JOIN)해야 사람이 이해할 수 있는 정보를 볼 수 있다.
SELECT
    p.name AS product_name,
    ad.attr_label,
    pa.attr_value
FROM product p
JOIN product_attribute pa ON p.product_id = pa.product_id
JOIN attribute_definition ad ON pa.attr_def_id = ad.attr_def_id
WHERE p.product_id = 1
ORDER BY ad.display_order;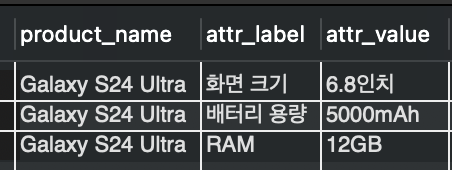
- 조회 쿼리에서 조인이 하나 늘어났다.
- 하지만 "attr_name"을 직접 입력하던 이전 방식과 비교했을 때, "attr_label"(화면 크기)처럼 사용자에게 보여주기 위한 이름을 별도로 관리할 수 있고, 오타로 인한 데이터 파편화를 막을 수 있다는 강력한 장점이 생겼다.
실무에서는 이렇게 메타데이터(속성 정의)와 실제 데이터(속성 값)를 분리하여 시스템의 유연성과 데이터 무결성을 동시에 잡는 설계를 자주 사용한다.
정리
- EAV 패턴: 테이블 구조 변경 없이 속성을 동적으로 추가할 수 있다.
- 메타데이터 관리: 속성 정의 테이블을 두어 데이터의 타입, 필수 여부, 화면 표시 순서 등을 체계적으로 관리한다
'데이터 베이스 > 설계 2편, 실무에서 반드시 마주치는 9가지 설계 패턴' 카테고리의 다른 글
| Ch08. JSON 설계 - EAV의 한계와 JSON 필요성 (0) | 2026.07.29 |
|---|---|
| Ch07. 동적 설계 EAV - EAV의 장단점과 주의사항 (0) | 2026.07.27 |
| Ch07. 동적 설계 EAV - EAV 패턴 실습 (0) | 2026.07.27 |
| Ch07. 동적 설계 EAV - EAV 패턴 (0) | 2026.07.27 |
| Ch07. 동적 설계 EAV - 기존 방식의 한계와 새로운 접근법 (0) | 2026.07.27 |